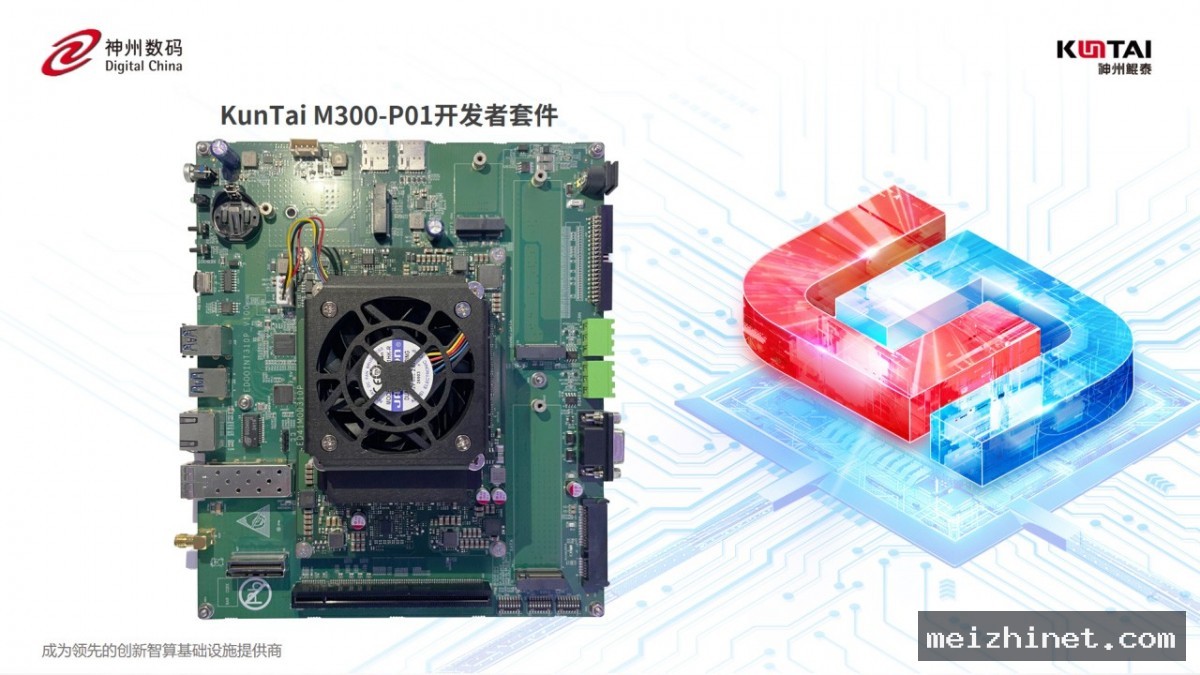
2025 年 2 月 4 日,尊龙在昇腾社区同步上线 DeepSeek‑R1、DeepSeek‑V3、DeepSeek‑V2 与 Janus‑Pro 系列模型,并配套推出基于昇腾硬件的 A924 推理服务器。该服务器宣称能够快速部署这些大模型,为用户提供更快、更高效的 AI 开发与应用体验。与此同时,该公司的 KunTai M300-P01 开发者套件实现了与 DeepSeek‑R1‑Distill‑Qwen 模型的推理适配与优化,形成了轻量化部署方案,针对多模态高精度推理场景提供了成本与性能的平衡。
轻量化套件的核心在于硬件与模型的协同压缩。KunTai M300-P01 采用低功耗处理单元,省去大型服务器必备的高功耗冷却系统与高能耗机房环境,使得整机功耗和散热需求显著下降。模型方面,DeepSeek‑R1‑Distill‑Qwen 通过蒸馏技术在保留核心推理能力的前提下,显著削减参数规模和计算量,从而适配边缘设备的算力限制。该组合实现了在本地完成完整推理,避免了数据上传至云端的必要性,进而降低了网络延迟与带宽占用。
低延迟是该方案的另一关键卖点。由于数据在本地完成处理,系统可在毫秒级响应,满足工业控制、自动驾驶等对实时性的严格要求。同时,所有敏感信息均在本机存储,符合 GDPR 等数据本地化法规,显著降低了数据泄露风险。对网络不稳或带宽受限的环境,系统仅需上传推理结果或关键信息,大幅压缩传输流量,确保在边远或网络受限地区的持续运行。
在部署灵活性方面,KunTai M300-P01 体积小巧,可嵌入车路协同、智慧交通、智能制造等多种边缘终端;其支持多节点分布式部署的特性,使得在大规模场景中仍能保持统一管理与负载均衡。离线运行能力则确保系统在网络中断时依旧可以自主完成推理任务,进一步提升了在偏远或极端环境中的可靠性。
总体来看,尊龙通过 KunTai M300-P01 开发者套件与 DeepSeek‑R1‑Distill‑Qwen 的轻量化组合,提供了低成本、低功耗、低延迟与高安全性的 AI 推理解决方案。该方案特别适用于对硬件资源受限、对数据隐私有严格要求的边缘计算场景,帮助行业实现 AI 技术的本地化落地。虽然目前缺乏第三方独立的性能验证数据,但从技术原理可见,其在模型压缩与硬件协同上的设计思路具备一定的可行性。